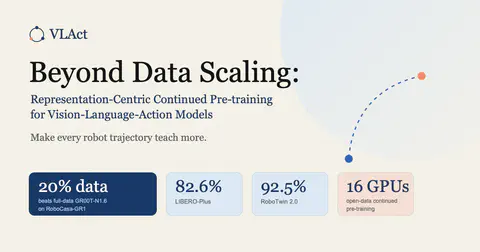
Beyond Data Scaling: Representation-Centric Continued Pre-training for Vision-Language-Action ModelsSenqiao Yang, Chengyao Wang, Yuxin Chen, Zixuan Wang, Longxiang Tang, Haokun Gui, Jinhui Ye, Changsheng Lu, Xiaoyang Wu, Mingkang Zhu, et al.NeurIPS 2026PDF Cite Code Video Page
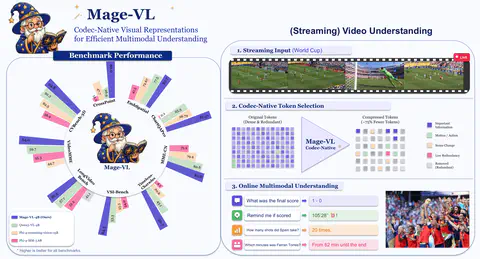
Mage-VL: An Efficient Codec-Native Streaming Multimodal Foundation ModelSenqiao Yang, Kaichen Zhang, Zhaoyang Jia, Jinghao Guo, Yifei Shen, et al.Microsoft Report 2026PDF Cite Code Page
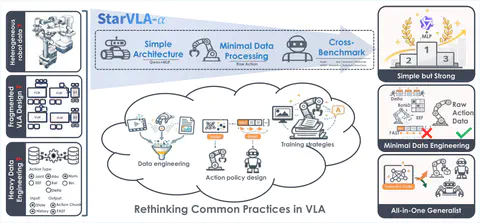
StarVLA-alpha: Reducing Complexity in Vision-Language-Action SystemsJinhui Ye, Ning Gao, Senqiao Yang, Jinliang Zheng, Zixuan Wang, Yuxin Chen, Pengguang Chen, Yilun Chen, et al.ECCV 2026PDF Cite Code Page
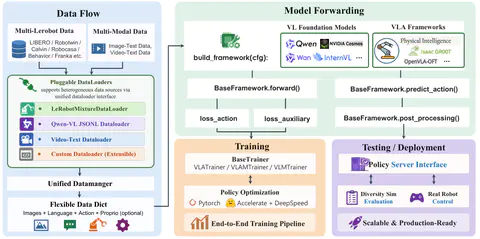
StarVLA: A Lego-like Codebase for Vision-Language-Action Model DevelopingSenqiao Yang, et al.Tech Report 2026PDF Cite Code Page
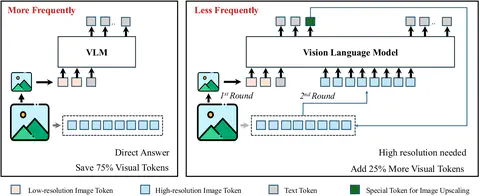
VisionThink: Smart and Efficient Vision Language Model via Reinforcement LearningSenqiao Yang, Junyi Li, Xin Lai, Jinming Wu, Wei Li, Zejun Ma, Bei Yu, Hengshuang Zhao, Jiaya JiaNeurIPS 2025PDF Cite Code Dataset Video Page
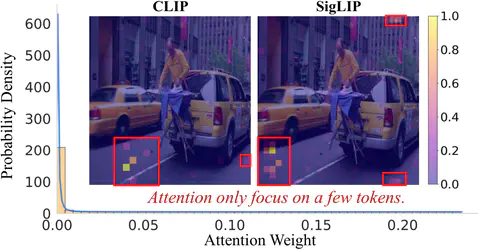
VisionZip: Longer is Better but Not Necessary in Vision Language ModelsSenqiao Yang, Yukang Chen, Zhuotao Tian, Chengyao Wang, Jingyao Li, Bei Yu, Jiaya JiaCVPR 2025 2024PDF Cite Code Video Page
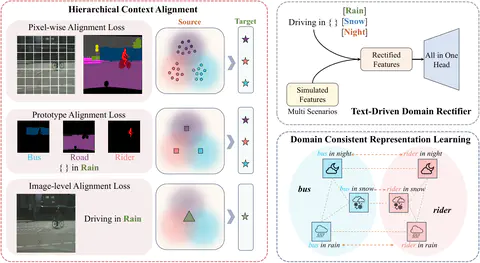
Unified Language-driven Zero-shot Domain AdaptationSenqiao Yang, Zhuotao Tian, Jiang Li, Jiaya JiaCVPR 2024PDF Cite Video Page
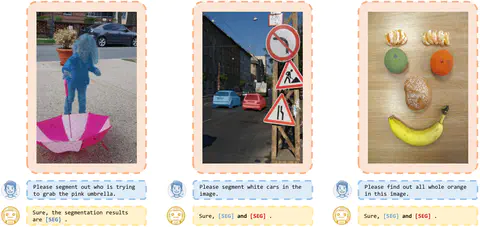
LISA++: An Improved Baseline for Reasoning Segmentation with Large Language ModelSenqiao Yang, Tianyuan Qu, Xin Lai, Zhuotao Tian, Bohao Peng, Shu Liu, Jiaya JiaTech Report 2023PDF Cite Dataset
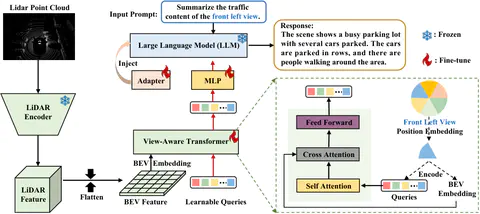
LiDAR-LLM: Exploring the Potential of Large Language Models for 3D LiDAR UnderstandingSenqiao Yang, Jiaming Liu, Ray Zhang, Mingjie Pan, Zoey Guo, Xiaoqi Li, Zehui Chen, Peng Gao, Yandong Guo, Shanghang ZhangAAAI 2025 2023PDF Cite Dataset Page